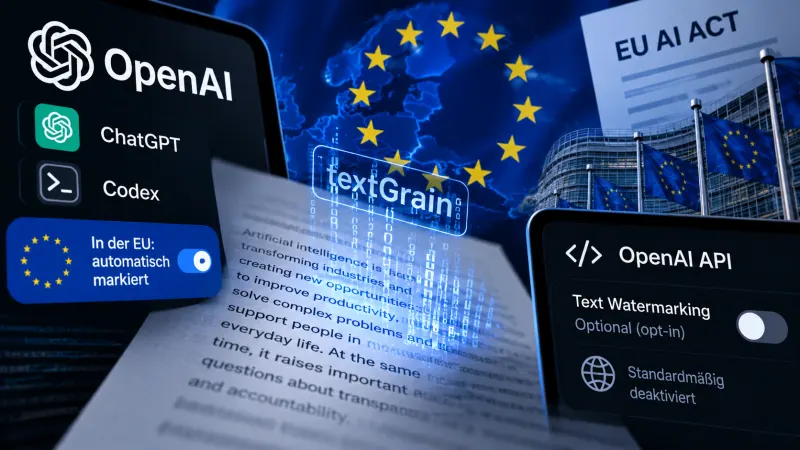
OpenAI führt ein statistisches Wasserzeichen für KI-generierte Texte ein. API-Kunden können die als textGrain bezeichnete Funktion bereits für Ausgaben bestimmter Modelle aktivieren. Innerhalb weniger Wochen sollen auch geeignete Textausgaben von ChatGPT und Codex in der Europäischen Union automatisch gekennzeichnet werden.
Damit reagiert OpenAI auf den EU AI Act, der von Anbietern generativer KI verlangt, maschinell erzeugte Inhalte in maschinenlesbarer Form identifizierbar zu machen. Die entscheidende Einschränkung steht allerdings in den Testergebnissen: Das Signal wird in kurzen Texten nicht zuverlässig erkannt und lässt sich durch nachträglichen Austausch von Wörtern stark abschwächen.
Für Leser, Plattformbetreiber und Unternehmen bedeutet das: textGrain ist kein allgemeiner KI-Detektor. Das Verfahren kann lediglich prüfen, ob ein Text noch genügend Spuren eines zuvor von OpenAI eingebetteten Signals enthält. Zwischen formaler Kennzeichnung und belastbarer Herkunftsprüfung bleibt damit eine erhebliche Lücke.
Ein statistisches Muster in der Wortwahl
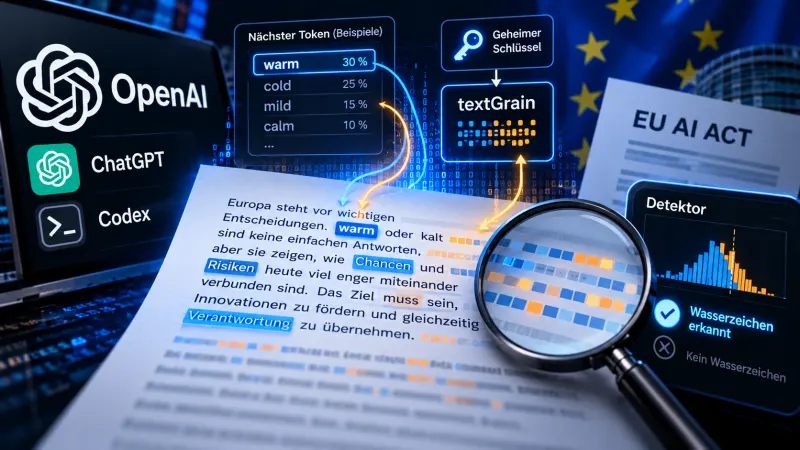
Sprachmodelle wählen bei der Generierung schrittweise neue Tokens aus einer Wahrscheinlichkeitsverteilung aus. textGrain greift in diese Auswahl ein und bevorzugt regelmäßig alternative Wörter, nach Möglichkeit Synonyme. Dadurch entsteht in der Wortfolge ein statistisches Muster, das für Menschen unsichtbar bleiben, von einem passenden Detektor aber erkannt werden soll.
Wie Bearbeitung das textGrain-Signal schwächt
Das Diagramm zeigt, wie OpenAI statistische Wortentscheidungen markiert und wie der Austausch von zehn beziehungsweise 25 Prozent der Wörter die gemessene Erkennungsrate reduziert.
OpenAI beschreibt das als „unsichtbares statistisches Signal“. Der zugehörige Detektor soll jedoch nicht allgemein verfügbar sein, sondern nur zugelassenen Forschern und Organisationen offenstehen. Wer einen Text prüfen will, ist daher nicht nur auf das Fortbestehen des Signals angewiesen, sondern auch auf Zugang zu OpenAIs Prüfverfahren.
Die Reichweite unterscheidet sich zudem nach Markt und Produkt. Bei ChatGPT und Codex soll OpenAI die Kennzeichnung auf geeignete EU-Ausgaben beschränken. API-Kunden können sie dagegen auch für Inhalte aktivieren, die außerhalb der Europäischen Union erzeugt werden. Anthropic verfolgt mit Googles SynthID-Text einen anderen Rollout und wendet seine Kennzeichnung weltweit an.
Kurze und bearbeitete Texte verlieren das Signal
Die Erkennungsleistung hängt deutlich von der Textlänge ab. Bei Passagen mit 200 Wörtern erkennt OpenAIs Detektor nach den vorliegenden Ergebnissen etwa 80 Prozent der Wasserzeichen. Bei 400 Wörtern steigt die Quote auf 95 Prozent. Das Verfahren sammelt gewissermaßen statistische Evidenz: Je weniger Text vorhanden ist, desto weniger markierte Wortentscheidungen kann es auswerten.
Noch deutlicher wirkt sich eine nachträgliche Bearbeitung aus. In Tests mit 400 Tokens sank die Erkennung von 92 auf 66 Prozent, nachdem zehn Prozent der Wörter durch Synonyme ersetzt worden waren. Bei einem Austausch von 25 Prozent der Wörter ließ sich das Signal nur noch in 17 Prozent der Fälle erkennen.
Dafür ist keine Veränderung der Aussage oder eine vollständige Neufassung erforderlich. Schon ein redaktioneller Durchgang, eine automatische Paraphrasierung oder eine Übersetzung mit anschließender Rückübertragung kann grundsätzlich jene Wortentscheidungen verändern, an denen das statistische Muster hängt. Die konkreten Testergebnisse belegen dabei den Effekt der Synonymersetzung; wie stark andere Bearbeitungsformen wirken, geht aus den gelieferten Daten nicht hervor.
Bei Code und Mathematik wird die Kennzeichnung schwieriger
Besonders problematisch sind funktionale Texte wie Programmcode oder mathematische Passagen. Dort gibt es weniger gefahrlose Alternativen: Ein scheinbar ähnliches Wort, Symbol oder Token kann die Funktion oder fachliche Bedeutung verändern. Entsprechend fällt die Erkennung in solchen Inhalten schwächer aus.
Das textGrain-Papier behandelt nach den vorliegenden Angaben zudem nicht, ob statistisch bevorzugte Wortvarianten die Bedeutung normaler Texte verändern können. Das bedeutet nicht, dass solche Veränderungen nachgewiesen sind. Es bleibt aber ein offener Zielkonflikt des Verfahrens: Das Wasserzeichen muss die Ausgabe weit genug beeinflussen, um messbar zu sein, darf dabei aber weder Präzision noch Aussage verändern.
Gerade bei Codex ist diese Einschränkung relevant. Ein Wasserzeichen für natürlichsprachliche Erläuterungen lässt sich leichter einbetten als in Code, bei dem Austauschmöglichkeiten begrenzt sind und kleine Änderungen operative Folgen haben können. Die Formulierung, dass nur „geeignete“ Ausgaben gekennzeichnet werden, ist deshalb mehr als eine technische Fußnote.
Compliance ist nicht dasselbe wie Herkunftsnachweis
OpenAIs Einführung erfüllt zunächst den Mechanismus, den die Regulierung verlangt: Der Anbieter versieht Ausgaben mit einem maschinenlesbaren Merkmal und stellt eine Methode zu dessen Erkennung bereit. Daraus folgt jedoch kein verlässliches System zur Bestimmung, ob ein beliebiger Text von einer KI stammt.
Ein negatives Ergebnis kann mehrere Ursachen haben. Der Text könnte von einem Menschen stammen, von einem nicht gekennzeichneten Modell erzeugt worden sein, aus einer Region oder einem Produkt ohne standardmäßige Markierung kommen oder nach der Generierung ausreichend bearbeitet worden sein. Selbst bei unverändert markierten Texten bleibt die Erkennung insbesondere bei kurzen Passagen unvollständig.
Damit eignet sich textGrain eher als Provenienzsignal für weitgehend unveränderte Ausgaben denn als belastbarer Filter gegen verschleierte KI-Texte oder Desinformation. Akteure, die ihre Nutzung verbergen wollen, erhalten durch die Wortsubstitution einen einfachen Ansatzpunkt. Gleichzeitig droht bei alltäglicher redaktioneller Bearbeitung derselbe Effekt, obwohl keine Umgehungsabsicht besteht.
Die Regulierung misst künftig auch die Haltbarkeit
Der Unterschied zwischen OpenAI und Anthropic liegt zunächst sichtbar im Rollout: OpenAI setzt standardmäßig auf eine EU-bezogene Einführung, Anthropic auf eine globale Anwendung. Ob das eine Verfahren Manipulation besser übersteht als das andere, lässt sich aus den vorliegenden Angaben nicht belastbar ableiten. Beide Ansätze greifen jedoch in die statistische Wortauswahl ein und stehen damit grundsätzlich vor dem Problem nachträglicher Textänderungen.
Für Unternehmen sollte ein erkanntes Wasserzeichen deshalb als ein Signal unter mehreren behandelt werden, nicht als abschließender Beweis. Umgekehrt darf ein fehlendes Signal nicht mit menschlicher Urheberschaft gleichgesetzt werden. Wer Herkunft verlässlich dokumentieren muss, benötigt zusätzliche Prozessdaten – etwa kontrollierte Erzeugungswege, interne Protokolle oder Freigaben – statt allein den fertigen Text zu untersuchen.
Die operative Schwäche von textGrain liegt somit nicht nur in einer einzelnen Erkennungsquote. Das Verfahren bindet den Herkunftsnachweis an genau jene Wortwahl, die beim Kopieren, Redigieren und Weiterverarbeiten besonders leicht verloren geht. OpenAI kann damit Ausgaben kennzeichnen. Ob diese Kennzeichnung den üblichen Lebenszyklus eines Textes übersteht, ist eine andere Frage.
Jens analysiert seit Jahren digitale Märkte, Preisbewegungen und Plattform-Strategien. Als Betreiber mehrerer datengetriebener Systeme wertet er täglich große Mengen an Produkt- und Trenddaten aus. Sein Fokus liegt auf Einordnung statt Hype: Was bedeutet eine Entwicklung wirklich für Nutzer, Preise und Märkte?