OpenAI hat dazu einen eigenen technischen Bericht veröffentlicht. Darin beschreibt das Unternehmen detailliert, wie das Wasserzeichen beim Generieren entsteht und wie es später wieder erkannt werden kann.
Technischer Bericht: textGrain: Entropy-Calibrated Watermarking for Language Model Text
Die eigentliche News zur Einführung in der EU haben wir hier zusammengefasst: EU zwingt ChatGPT zum Wasserzeichen – über die API bleibt es freiwillig.
Das Wasserzeichen steckt in der Wahrscheinlichkeit
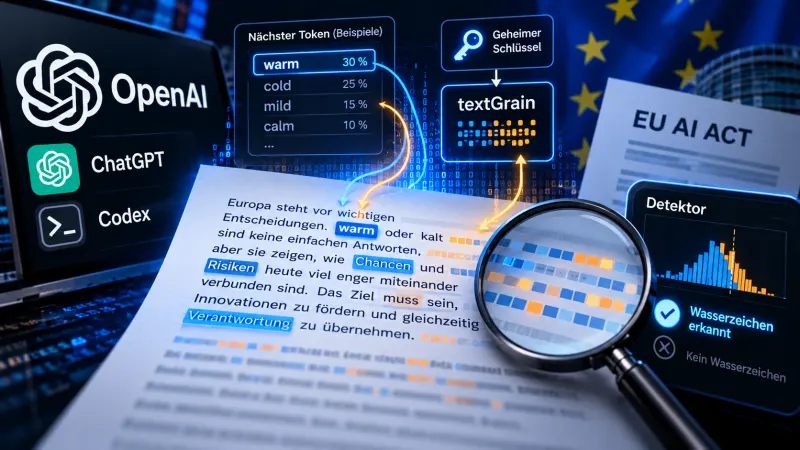
Sprachmodelle erzeugen Text Token für Token. Bei jedem Schritt berechnet das Modell zunächst eine Wahrscheinlichkeitsverteilung für mögliche nächste Wörter oder Wortbestandteile.
Vereinfacht könnte das Modell beispielsweise folgende Möglichkeiten sehen:
- „warm“ – 30 Prozent
- „cold“ – 25 Prozent
- „mild“ – 15 Prozent
- „calm“ – 10 Prozent
Normalerweise wird aus dieser Verteilung ein Token ausgewählt.
textGrain greift genau an dieser Stelle ein.
OpenAI kombiniert die ursprüngliche Wahrscheinlichkeitsverteilung mit pseudorandomisierten Werten, die aus einem geheimen Schlüssel und dem bereits geschriebenen Kontext erzeugt werden.
Dadurch entsteht eine statistische Abhängigkeit zwischen dem geheimen Schlüssel und den tatsächlich ausgewählten Tokens.
Für einen Leser ist davon nichts sichtbar.
Kein versteckter Text und keine Metadaten
Das ist ein wichtiger Unterschied zu klassischen digitalen Wasserzeichen.
textGrain hängt keine Kennung an einen Absatz und schreibt keine versteckten Zeichen in den Text. Kopiert man einen Absatz in einen einfachen Texteditor, gibt es dort nichts Zusätzliches zu entdecken.
Das Wasserzeichen befindet sich vielmehr in der statistischen Struktur der Wortauswahl.
Der Detektor fragt später vereinfacht:
Passen die in diesem Text ausgewählten Tokens ungewöhnlich gut zu dem Muster, das mit unserem geheimen Schlüssel erzeugt worden wäre?
Je länger der Text ist, desto mehr solcher Einzelentscheidungen kann der Detektor untersuchen.
Der Schlüssel kennt den vorherigen Kontext
Für jede relevante Position erzeugt textGrain pseudorandomisierte Werte aus einem geheimen Schlüssel und einem begrenzten Fenster des vorherigen Textes.
Dadurch hängt das statistische Muster nicht nur vom Schlüssel ab, sondern auch davon, was unmittelbar davor geschrieben wurde.
Im technischen Bericht beschreibt OpenAI diesen Zusammenhang als „keyed randomness“.
Der gleiche Schlüssel und der gleiche Kontext ermöglichen es dem späteren Detektor, die für diese Position verwendeten Zufallswerte erneut zu rekonstruieren.
Das Vokabular wird in Gruppen aufgeteilt
OpenAI manipuliert dabei nicht direkt jedes einzelne Token unabhängig voneinander.
textGrain teilt mögliche Tokens zunächst in sogenannte Blöcke auf.
Die Wahrscheinlichkeit aller Tokens innerhalb eines Blocks wird zusammengefasst. Anschließend entscheidet das Watermarking-Verfahren statistisch, welcher Block bevorzugt wird.
Innerhalb des ausgewählten Blocks bleiben die relativen Wahrscheinlichkeiten der einzelnen Tokens erhalten.
Das reduziert den Rechenaufwand und soll gleichzeitig verhindern, dass das Wasserzeichen die natürliche Token-Verteilung unnötig stark verändert.
Das „Entropy Budget“ bestimmt die Stärke
Einer der zentralen Begriffe des technischen Berichts ist das sogenannte Entropy Budget.
Ein Sprachmodell enthält bei der Generierung bewusst Zufall. Bei vielen Positionen gibt es mehrere plausible nächste Tokens.
Ein starkes Wasserzeichen könnte diese Freiheit erheblich reduzieren: Der geheime Schlüssel würde dann einen immer größeren Einfluss darauf bekommen, welches Token ausgewählt wird.
Das hätte einen Vorteil: Das Wasserzeichen wäre leichter erkennbar.
Es hätte aber auch einen Nachteil: Die Ausgabe könnte weniger vielfältig werden oder sich stärker von der ursprünglichen Verteilung des Modells entfernen.
OpenAI begrenzt deshalb, wie viel dieser ursprünglichen Sampling-Zufälligkeit für das Wasserzeichen geopfert werden darf.
Genau das bezeichnet das Unternehmen als Entropy Budget.
Mehr Wasserzeichen bedeutet weniger Zufall
Der grundlegende Zielkonflikt ist einfach:
- Kein Einfluss des Schlüssels: kein erkennbares Wasserzeichen.
- Sehr großer Einfluss des Schlüssels: starkes Wasserzeichen, aber weniger Sampling-Freiheit.
textGrain versucht, einen Punkt dazwischen zu finden.
OpenAI beschreibt die mathematische Grundlage dafür als ein Problem des „Optimal Transport“ mit KL-Regularisierung.
Die KL-Divergenz misst dabei vereinfacht, wie stark sich die durch das Wasserzeichen beeinflusste Auswahl von einer unabhängigen Auswahl entfernt.
Im textGrain-Verfahren entspricht diese Größe zugleich dem durchschnittlichen Verlust an Sampling-Entropie.
Damit bekommt die Stärke des Wasserzeichens eine direkt messbare informationstheoretische Bedeutung.
Der Detektor braucht das ursprüngliche Modell nicht
Besonders interessant ist die andere Seite des Systems: die Erkennung.
OpenAI schreibt im technischen Bericht ausdrücklich, dass der Detektor weder das Modell kennen muss, das den Text erzeugt hat, noch das bei der Generierung verwendete Entropy Budget.
Er benötigt den erzeugten Text und den geheimen Schlüssel sowie dieselben Regeln für Tokenisierung, Kontextfenster und Token-Blöcke.
Aus dem Text rekonstruiert er Position für Position die pseudorandomisierten Werte, die bei der Generierung relevant gewesen wären.
Anschließend prüft er, ob die tatsächlich gefundenen Tokens statistisch auffällig häufig zu den durch den Schlüssel bevorzugten Bereichen gehören.
Aus vielen kleinen Signalen entsteht ein Treffer
Ein einzelnes Wort reicht deshalb nicht aus, um ein Wasserzeichen zuverlässig festzustellen.
Der Detektor sammelt für viele Positionen statistische Einzelwerte und addiert diese zu einem Gesamtsignal.
Dieses Ergebnis wird anschließend mit der erwarteten Verteilung für nicht markierten Text verglichen.
Erst wenn das Ergebnis einen festgelegten Schwellenwert überschreitet, wird ein Wasserzeichen angenommen.
Genau deshalb funktioniert das Verfahren bei längeren Texten wesentlich besser als bei kurzen Antworten.
Warum Umschreiben das Wasserzeichen zerstört
Aus der Funktionsweise ergibt sich gleichzeitig die größte Schwäche des Systems.
Das Wasserzeichen steckt in den konkreten Token-Entscheidungen des Modells.
Wer einen Text anschließend umformuliert, ersetzt genau diese Entscheidungen.
Schon Synonyme können ursprüngliche Tokens entfernen. Größere Umformulierungen verändern zusätzlich den vorherigen Kontext und damit die Werte, die der Schlüssel für nachfolgende Stellen erzeugen würde.
Eine Übersetzung verändert praktisch die gesamte Tokenfolge.
Das erklärt, warum OpenAI selbst darauf hinweist, dass Umschreiben oder Übersetzen die Erkennung erheblich verschlechtern oder das Wasserzeichen vollständig entfernen kann.
textGrain ist kein forensischer Fingerabdruck
Der Begriff Wasserzeichen kann deshalb leicht einen falschen Eindruck erzeugen.
textGrain funktioniert nicht wie ein eindeutiger digitaler Fingerabdruck, der unabhängig von Veränderungen dauerhaft in einem Dokument steckt.
Es ist ein statistisches Signal.
Ein ausreichend langer, weitgehend unveränderter Text kann starke Hinweise liefern, dass er mit einem bestimmten Watermarking-System erzeugt wurde.
Je stärker ein Text anschließend bearbeitet wird, desto weniger vom ursprünglichen Signal bleibt erhalten.
Auch der geheime Schlüssel ist entscheidend
Der Detektor kann das Muster nur rekonstruieren, weil er Zugriff auf den geheimen Schlüssel besitzt.
Ohne diesen Schlüssel kennt ein Außenstehender nicht die pseudorandomisierte Zuordnung, die während der Generierung verwendet wurde.
Das erklärt auch, warum OpenAI seinen eigenen Detektor zunächst nicht allgemein öffentlich anbietet.
OpenAI will den Zugang zunächst auf ausgewählte Forscher und Organisationen beschränken und das Verfahren weiter untersuchen.
Die technische Idee ist eleganter als der Begriff Wasserzeichen vermuten lässt
textGrain versucht ein schwieriges Problem zu lösen.
OpenAI möchte einerseits ein statistisch messbares Herkunftssignal erzeugen. Andererseits soll sich die Qualität und Vielfalt der Modellantworten möglichst wenig verändern.
Deshalb wird kein zusätzlicher Inhalt in einen Text eingebettet.
Stattdessen wird die ohnehin vorhandene Wahrscheinlichkeit bei der Token-Auswahl so gesteuert, dass ein Besitzer des geheimen Schlüssels später eine statistische Abhängigkeit erkennen kann.
Für normale Nutzer bleibt diese Manipulation unsichtbar.
Für einen Detektor können sich über Hunderte Tokens dagegen genügend kleine Abweichungen ansammeln, um das Signal statistisch nachzuweisen.
Und genau darin liegt die Grenze des Systems
OpenAI hat damit kein universelles Verfahren geschaffen, das zuverlässig beantworten kann, ob irgendein Text von einer KI stammt.
textGrain beantwortet eine deutlich engere Frage:
Passt dieser Text statistisch zu einem Wasserzeichen, das mit einem bestimmten geheimen Schlüssel während der OpenAI-Generierung eingebettet wurde?
Das ist technisch wesentlich präziser als klassische KI-Textdetektoren.
Aber es funktioniert nur, solange genügend vom ursprünglichen statistischen Muster erhalten bleibt.
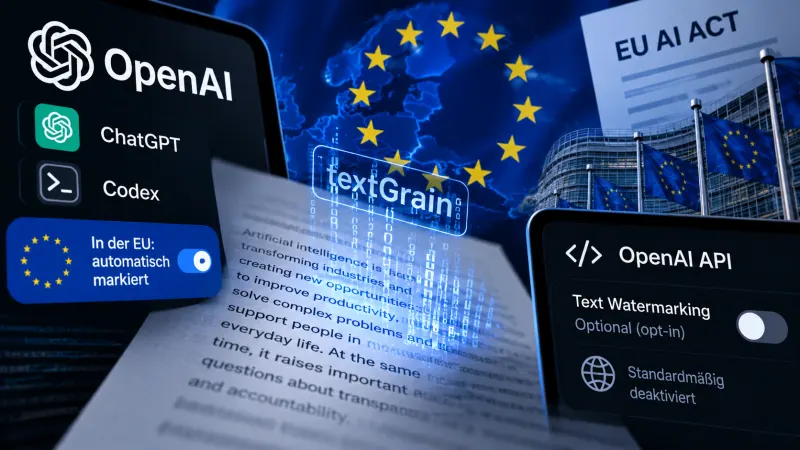
Das erklärt den scheinbaren Widerspruch der neuen EU-Regelung: OpenAI kann Texte maschinenlesbar markieren – und gleichzeitig offen darauf hinweisen, dass diese Markierung durch Bearbeitung wieder verschwinden kann.
Der vollständige technische Bericht von OpenAI ist hier verfügbar: textGrain: Entropy-Calibrated Watermarking for Language Model Text.