Stattdessen trifft Jev Entscheidungen.
Sehr schnell. Und sehr günstig.
Das macht das System-One-Modell von TypeSafe AI vor allem für eine Aufgabe interessant, für die Entwickler bislang häufig viel zu große Modelle eingesetzt haben: kleine Entscheidungen innerhalb eines größeren KI-Systems.
Man könnte Jev deshalb auch deutlich einfacher beschreiben:
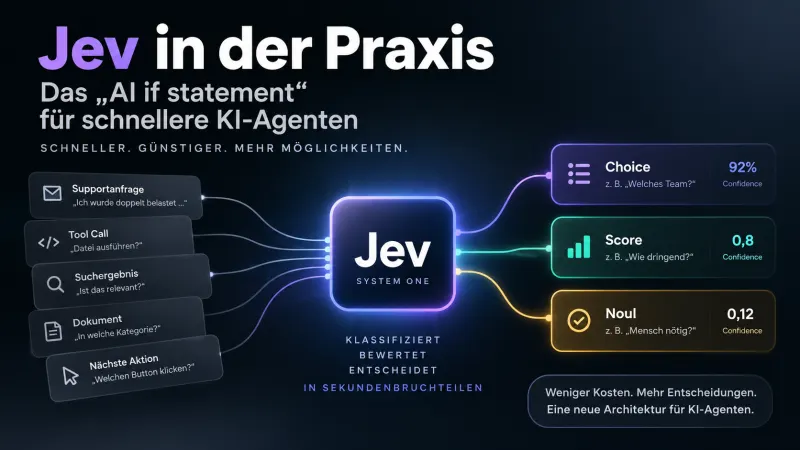
Jev ist ein „AI if statement“.
Und genau darin könnte seine eigentliche Bedeutung liegen.
Jev soll nicht GPT oder Claude ersetzen
Wer Jev als weiteren Konkurrenten für ChatGPT, Claude oder Gemini betrachtet, versteht das Konzept falsch.
TypeSafe beschreibt Jev als erstes öffentlich verfügbares „System One Model“. Statt Text Token für Token zu generieren, bekommt das Modell einen Zustand und liefert strukturierte Entscheidungen samt Wahrscheinlichkeiten zurück.
Das können beispielsweise Fragen sein wie:
- Ist diese Supportanfrage dringend?
- Welches Modell sollte diese Aufgabe bearbeiten?
- Ist dieser Suchtreffer relevant?
- Darf ein Agent diesen Befehl ausführen?
- Muss ein Mensch eingeschaltet werden?
Jev liefert darauf keine Erklärung mit fünf Absätzen.
Es liefert eine Entscheidung.
LangChain beschreibt deshalb eine Architektur, in der ein klassisches LLM weiterhin für offene Aufgaben, Schlussfolgerungen und Textgenerierung zuständig ist, während Jev schnelle strukturierte Entscheidungen innerhalb des Agenten übernimmt.
Genau diese Aufgabenteilung ist interessant.
Das Problem moderner KI-Agenten: zu viele kleine LLM-Aufrufe
Ein KI-Agent besteht längst nicht nur aus einem Modell.
Typischerweise läuft ungefähr folgender Prozess:
Aufgabe → Modell → Werkzeug → Ergebnis → Bewertung → nächste Aktion → Werkzeug → erneute Bewertung
Bei jedem dieser Schritte müssen Entscheidungen getroffen werden.
Soll der Agent weitermachen? War das Ergebnis erfolgreich? Welches Tool soll verwendet werden? Welches Modell ist für die nächste Aufgabe geeignet? Ist eine Aktion möglicherweise gefährlich?
Viele Systeme lösen solche Fragen heute wiederum mit einem normalen Sprachmodell.
Das funktioniert – ist aber vergleichsweise langsam und teuer.
Jev versucht genau diese Entscheidungsschicht zu übernehmen.
1. Jev als Router zwischen verschiedenen KI-Modellen
Einer der offensichtlichsten Anwendungsfälle ist Model Routing.
Nicht jede Anfrage braucht das leistungsfähigste verfügbare Modell.
Eine einfache Klassifikation kann ein kleines und günstiges Modell erledigen. Eine komplexe Programmieraufgabe oder umfangreiche Analyse kann dagegen an ein leistungsfähigeres Modell weitergereicht werden.
Jev sitzt dabei vor den eigentlichen Modellen.
Anfrage → Jev → einfach → kleines Modell
oder:
Anfrage → Jev → komplex → großes Reasoning-Modell
LangChain hat genau dieses Prinzip bereits in seine Jev-Integration aufgenommen. Jev klassifiziert die Anfrage anhand vorgegebener Kriterien und entscheidet anschließend, welches Modell verwendet werden soll.
Das Interessante daran ist weniger die einzelne Entscheidung als deren Preis.
Ein Router muss bei praktisch jeder Anfrage laufen.
Je günstiger dieser Entscheidungsschritt wird, desto häufiger lässt er sich einsetzen.
2. Jev als Sicherheitskontrolle für KI-Agenten
Noch interessanter wird es bei Agenten, die tatsächlich Aktionen durchführen dürfen.
Coding-Agenten können beispielsweise Dateien verändern, Programme starten oder Shell-Befehle ausführen.
Vor einer solchen Aktion kann eine zusätzliche Entscheidungsschicht prüfen:
Ist diese Aktion sicher genug für den automatischen Modus?
LangChain hat dafür bereits eine experimentelle AutoModeMiddleware gezeigt. Jev bewertet dabei Tool Calls, bevor diese ausgeführt werden.
Das ersetzt keine vollständige Sicherheitsarchitektur.
Aber es zeigt ein wichtiges Prinzip:
Ein großes Sprachmodell muss nicht jede einzelne Kontrollentscheidung selbst treffen.
Zwischen Agent und Werkzeug kann eine sehr schnelle Klassifikationsschicht sitzen.
3. Browser-Agenten werden schneller
Besonders anschaulich zeigt das Projekt jev-ultrafast, wofür Jev eingesetzt werden kann.
Bei Browser-Agenten entsteht ständig eine neue Auswahl möglicher Aktionen.
Der Agent sieht beispielsweise:
- Eingabefelder
- Buttons
- Dropdowns
- Datumsauswahl
- Links
- Ergebnislisten
Statt ein großes Sprachmodell jedes Mal ausführlich überlegen zu lassen, welche Aktion als Nächstes sinnvoll ist, kann Jev aus dem bereits vorhandenen Aktionsraum auswählen.
Im veröffentlichten Google-Flights-Demo benötigte der Agent 7,073 Sekunden für die Aufgabe.
Im dokumentierten Vergleich sank die Median-Laufzeit von rund 9,45 auf 7,09 Sekunden.
Gleichzeitig muss dieser Benchmark eingeordnet werden: Die Entwickler selbst weisen darauf hin, dass nur wenige Wiederholungen einer einzelnen Aufgabe getestet wurden.
Es ist damit kein allgemeingültiger Beweis dafür, dass jeder Browser-Agent automatisch schneller wird.
Das Architekturprinzip wird trotzdem sehr deutlich:
Das große Modell wird nur dort eingesetzt, wo tatsächlich Sprachverständnis oder Generierung notwendig ist. Entscheidungen über vorhandene Optionen übernimmt Jev.
4. Jev könnte KI-Evaluierungen deutlich günstiger machen
Ein besonders interessanter Test erschien am 20. September bei LangChain.
Dort wurde Jev nicht als Router oder Browser-Steuerung eingesetzt, sondern als Bewertungsmodell für einen KI-Agenten.
Solche „LLM-as-a-Judge“-Systeme sind inzwischen weit verbreitet.
Ein Modell erstellt eine Antwort – und ein zweites Modell bewertet anschließend, ob diese Antwort gut war.
Das Problem:
Damit entsteht für die Qualitätskontrolle praktisch ein weiterer vollständiger LLM-Aufruf.
LangChain testete deshalb, ob Jev diesen Schritt übernehmen kann.
Im veröffentlichten Test benötigte Jev durchschnittlich rund 0,44 Sekunden pro Bewertung und kostete ungefähr 0,00035 US-Dollar pro Aufruf.
Bei der getesteten binären Pass/Fail-Bewertung stimmte Jev in den wiederholten Durchläufen mit den zuvor festgelegten menschlichen Bewertungen überein.
Allerdings war der Test klein und eng begrenzt. LangChain weist selbst darauf hin, dass sich das Ergebnis nicht ohne Weiteres auf andere Agenten und komplexere Produktionssysteme übertragen lässt.
Gerade dieser Punkt ist entscheidend.
Jev muss nicht jedes große Modell ersetzen.
Es reicht, wenn bestimmte Bewertungen plötzlich so günstig werden, dass Entwickler sie an Stellen einsetzen können, an denen bisher überhaupt keine Bewertung stattfand.
Der eigentliche Vorteil könnte nicht Geschwindigkeit, sondern Häufigkeit sein
TypeSafe nennt für eigene Workflow-Benchmarks Werte von bis zu 193,6-mal höherer Geschwindigkeit und 444,6-mal geringeren Kosten.
Solche Zahlen sollte man allerdings nicht ohne Kontext übernehmen.
Die Ergebnisse stammen aus ausgewählten Workflows des Herstellers und zeigen damit eher, was unter günstigen Bedingungen möglich ist, als einen universellen Geschwindigkeitsvorteil für jede Anwendung.
Vielleicht sind diese großen Multiplikatoren ohnehin nicht der entscheidende Punkt.
Die interessantere Frage lautet:
Was passiert, wenn eine KI-Entscheidung so billig wird, dass wir sie praktisch überall einsetzen können?
Nicht einmal pro Nutzeranfrage.
Sondern:
- einmal pro Datenbankzeile
- einmal pro Suchergebnis
- einmal pro Dokumentabschnitt
- einmal pro Tool Call
- einmal pro Agentenschritt
- einmal pro Datei
- einmal pro Nachricht
Genau hier greift auch der Name Jev.
TypeSafe benannte das Modell nach dem Ökonomen William Stanley Jevons und dem bekannten Jevons-Paradoxon.
Vereinfacht lautet dieses: Wird die Nutzung einer Ressource wesentlich effizienter, muss der Gesamtverbrauch nicht sinken. Durch neue Anwendungen kann er sogar steigen.
Auf KI übertragen lautet die These:
Wenn maschinelle Entscheidungen extrem billig werden, betreiben wir nicht einfach dieselben KI-Systeme günstiger. Wir lassen KI wesentlich mehr Entscheidungen treffen.
Jev kann trotzdem falsch liegen
Ein Punkt im Marketing rund um Jev verdient besondere Aufmerksamkeit.
TypeSafe betont, dass Jev keine ungültigen Antworten erzeugt.
Technisch steckt dahinter ein nachvollziehbarer Gedanke: Jev generiert keinen freien Text und kann keine Antwort außerhalb der definierten Typen produzieren.
Wenn drei Kategorien erlaubt sind, erhält man eine dieser drei Kategorien.
Damit verschwinden Probleme wie kaputtes JSON oder Antworten, die plötzlich Markdown statt der erwarteten Datenstruktur enthalten.
Aber:
Type Safety ist nicht gleich Correctness.
Jev kann eine formal gültige Antwort liefern und trotzdem die falsche Kategorie auswählen.
Auch ein Sicherheitsprüfer kann eine gefährliche Aktion fälschlicherweise als unproblematisch einstufen.
Auch ein Router kann eine schwierige Aufgabe an das falsche Modell schicken.
Und auch ein Evaluator kann sehr konsistent zu einer falschen Bewertung kommen.
Jev sollte deshalb nicht als unfehlbare Entscheidungsmaschine verstanden werden.
Der Confidence Score ist deshalb entscheidend
Genau hier wird ein weiteres Merkmal von Jev wichtig.
Das System liefert nicht nur eine Entscheidung, sondern auch Wahrscheinlichkeiten und Confidence-Werte.
Damit kann Software beispielsweise eine Eskalationslogik definieren:
Hohe Sicherheit → automatisch ausführen
Mittlere Sicherheit → zusätzliche Prüfung
Niedrige Sicherheit → größeres Modell oder Mensch
Damit entsteht etwas, das für produktive KI-Systeme möglicherweise wichtiger ist als die eigentliche Klassifikation:
eine kontrollierbare Eskalationslogik.
Jev muss nicht jede Anfrage perfekt beantworten.
Entscheidend ist vielmehr, wie zuverlässig sich unsichere Fälle erkennen und an eine stärkere Instanz weiterreichen lassen.
Nicht alles sollte Jev erledigen
Für viele Aufgaben bleibt ein klassisches Sprachmodell notwendig.
Jev ist beispielsweise nicht dafür gedacht, wenn eine Anwendung:
- Texte schreiben soll
- neue Ideen entwickeln soll
- komplexe Zusammenhänge erklären muss
- unbekannte Antwortmöglichkeiten erzeugen soll
- lange Schlussfolgerungen durchführen muss
- eine ausführliche Begründung liefern soll
Jev funktioniert besonders gut dort, wo die möglichen Aktionen bereits bekannt sind.
Das führt zu einer einfachen Architekturregel:
Optionen mit Code erzeugen. Jev auswählen lassen.
Ein Browser-Agent kennt seine anklickbaren Elemente.
Ein RAG-System kennt seine gefundenen Dokumente.
Ein Modell-Router kennt seine verfügbaren Modelle.
Ein Agent kennt seine Tools.
Jev muss nichts davon erfinden.
Es entscheidet lediglich, welche vorhandene Möglichkeit am besten zum aktuellen Zustand passt.
Das könnte der interessantere KI-Trend sein
Die vergangenen Jahre wurden von einem einfachen Wettbewerb geprägt:
Größere Modelle, größere Kontextfenster, mehr Reasoning und bessere Benchmarks.
Jev zeigt eine andere Richtung.
Vielleicht besteht die nächste Generation leistungsfähiger KI-Systeme nicht aus einem einzigen Modell, das alles erledigt.
Stattdessen könnten unterschiedliche Modelle hochspezialisierte Rollen übernehmen.
Ein leistungsfähiges Reasoning-Modell denkt.
Ein günstiges Sprachmodell schreibt.
Ein Embedding-Modell sucht.
Und ein Modell wie Jev entscheidet ständig, was als Nächstes passieren soll.
Damit wäre Jev weniger ein neuer ChatGPT-Konkurrent als eine neue Infrastrukturkomponente.
Eine Art intelligentes if.
Und möglicherweise ist genau das spannender als der nächste Chatbot.
Denn in produktiven KI-Agenten werden sehr viel mehr Entscheidungen getroffen als Antworten geschrieben.
Quellen