Forscher des MIT Computer Science and Artificial Intelligence Laboratory haben ein großes Sprachmodell direkt in die Gewichte eines anderen KI-Modells eingreifen lassen. OpenAIs GPT-6 Astra veränderte 131.072 Parameter von Qwen3.5-0.8B – 0,016 Prozent der insgesamt rund 800 Millionen Parameter. Ohne Gradientenabstieg und ohne klassische Trainingsschleife stieg die Punktzahl des kleineren Modells im Mathematik-Benchmark MATH-500 von 7,9 auf 48,1 Prozent.
Der Befund klingt zunächst nach einer Alternative zum aufwendigen Nachtrainieren. Tatsächlich ist er enger und gerade deshalb interessant: Astra brachte Qwen nicht in erster Linie neue Mathematik bei, sondern reparierte einen konkreten Fehlermodus. Das Modell blieb zuvor häufig in langen Gedankenschleifen hängen und lieferte vor Erreichen des Token-Limits keine Antwort. Die KI-Intervention setzte damit eher eine bereits vorhandene Fähigkeit frei, als eine neue zu erzeugen.
Das Team aus Rikiya Takehi, Jayden Teoh, Alex Zhang und Omar Khattab nennt die Methode Weight-Space Programming. Der Forschungsbericht „Sparks of Weight-Space Programming“ wurde am 2. November 2026 veröffentlicht. Die Autoren bezeichnen die Resultate selbst als sehr frühe Experimente; die Arbeit ist bislang nicht begutachtet und besitzt keine DOI.
Der größte Sprung entstand durch weniger Leerlauf
Auf MATH-500 brachen vor der Bearbeitung 93,0 Prozent der Antworten am Token-Limit ab. Nach der Änderung waren es noch 33,1 Prozent. Parallel dazu verbesserte sich Qwen3.5-0.8B bei IFEval, einem Test für die Befolgung von Anweisungen, von 21,0 auf 62,3 Prozent. Die vielfach höheren Benchmarkwerte sind damit real, dürfen aber nicht mit einer ebenso großen Erweiterung des Wissens oder der mathematischen Fähigkeiten gleichgesetzt werden.
So funktioniert Weight-Space Programming im Experiment
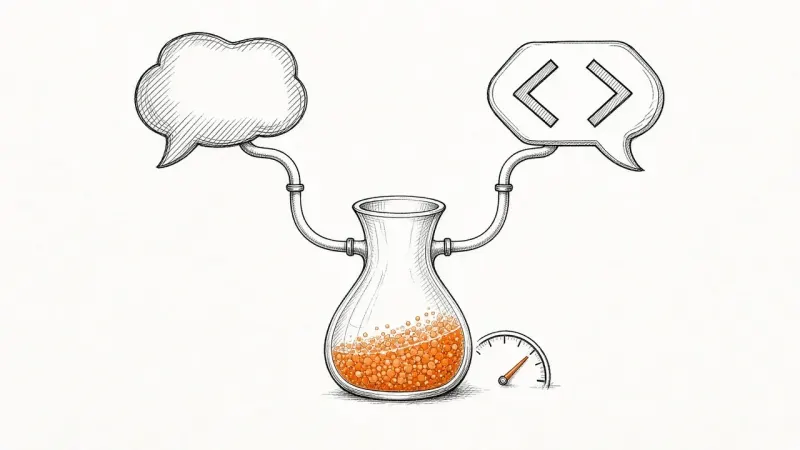
GPT-6 Astra analysiert die Gewichte von Qwen3.5-0.8B, verändert 0,016 Prozent der Parameter und reduziert damit vor allem abgebrochene Antworten durch Denkschleifen.
Ein Kontrollversuch stützt diese Einschränkung. Bei Gemma 3 270M, das nur selten in vergleichbare Schleifen gerät, konnte die Methode die mathematische Leistung nicht verbessern. Weight-Space Programming scheint in diesem Versuch also vor allem Blockaden zu beseitigen, die vorhandene Fähigkeiten verdecken. Für die praktische Bewertung ist das entscheidender als die plakative Versechsfachung des MATH-500-Werts.
Das Modell wird nicht trainiert, sondern gezielt gepatcht
Beim üblichen Training bestimmt ein Optimierungsverfahren anhand vieler Beispiele und einer Verlustfunktion, wie Gewichte schrittweise verändert werden. Astra durfte nach Angaben der Forscher keine Trainingsschleife schreiben. Stattdessen sollte das Modell die numerischen Gewichte lesen, ihre Funktion untersuchen und passende Werte direkt einsetzen.
Der Vorgang ähnelt damit eher dem Debugging als dem Lernen: Ein Fehlverhalten wird diagnostiziert, eine kleine Teilmenge des Systems geändert und das Ergebnis erneut getestet. Dass 0,016 Prozent der Parameter genügten, ist kein Beleg dafür, dass sich jedes Modell auf diese Weise reparieren lässt. Es zeigt jedoch, dass messbares Fehlverhalten mitunter an einer sehr kleinen Gewichtskonfiguration hängen kann.
In einem weiteren Experiment erzeugte GPT-6 Astra die Gewichte eines neuronalen Netzes für das Spiel Breakout vollständig neu und ohne vorheriges Training. Das Netz übertraf teilweise Modelle, die mit 100 Millionen PPO-Schritten trainiert worden waren. Auch das ist ein experimenteller Einzelbefund, erweitert den Ansatz aber über die Reparatur vorhandener Modelle hinaus: Ein Sprachmodell kann offenbar nicht nur Programmcode, sondern unter bestimmten Bedingungen auch direkt ausführbare Gewichtskonfigurationen entwerfen.
Der Engpass verschiebt sich zur Kontrolle der Eingriffe
Sollte sich die Methode auf größere Modelle und weitere Fehlerklassen übertragen lassen, könnte sie bestimmte Wartungsaufgaben verkürzen. Für einen eng umrissenen Defekt wäre dann nicht zwangsläufig ein neuer Trainingslauf mit Datensatz, Optimierer und vielen Iterationen nötig. Interessant wäre das besonders bei Verhaltensproblemen, die klar erkennbar und messbar sind, etwa Schleifen, unerwünschter Zustimmung oder einzelnen Fehlsteuerungen.
Das beseitigt den operativen Aufwand allerdings nicht, sondern verlagert ihn. Ein direkt veränderter Parameterbestand muss versioniert, reproduzierbar geprüft und mit unveränderten Modellständen verglichen werden. Ein besserer Wert in einem Benchmark reicht nicht aus: Betreiber müssten kontrollieren, ob der Eingriff an anderer Stelle Fähigkeiten beschädigt oder neues Fehlverhalten erzeugt. Je weniger Menschen die konkrete Wirkung einzelner Gewichte nachvollziehen können, desto wichtiger werden automatisierte Tests, Rückfalloptionen und eine genaue Dokumentation jeder Änderung.
Auch der Zugang ist eine harte Voraussetzung. Weight-Space Programming setzt voraus, dass die Gewichte des Zielmodells tatsächlich ausgelesen und verändert werden können. Bei geschlossenen Modellen, die ausschließlich über eine API angeboten werden, liegt diese Möglichkeit beim Anbieter und nicht beim Kunden. Sollte die Technik belastbar werden, stärkt sie daher zunächst jene Labore und Plattformen, die zugleich über starke Steuerungsmodelle, offene Gewichtszugriffe und umfangreiche Evaluationssysteme verfügen.
Noch kein Ersatz für Training
Die Forscher wollen als Nächstes einen standardisierten Benchmark und eine technische Testumgebung für Weight-Space Programming entwickeln. Erst solche Vergleichstests können zeigen, ob Astra hier eine allgemein nutzbare Methode demonstriert hat oder vor allem einen günstig gelagerten Fehler in einem kleinen Modell fand.
Weitergehende Ziele wie weniger katastrophales Vergessen, bessere Interpretierbarkeit oder rekursive Selbstverbesserung sind bislang Aussichten, keine nachgewiesenen Ergebnisse dieser Experimente. Insbesondere folgt aus der Bearbeitung eines fremden Modells nicht automatisch, dass ein System sich selbst zuverlässig verbessern könnte.
Die unmittelbare Bedeutung liegt deshalb nicht im Ende des Trainings. Sie liegt in einer neuen Wartungsebene: Modellgewichte könnten von einem kaum direkt bearbeitbaren Endprodukt zu einem gezielt patchbaren Bestandteil werden. Dann entscheidet nicht allein, ob eine KI passende Werte schreiben kann. Entscheidend wird, ob ihre Änderungen enger geprüft werden können, als ein kompletter Trainingslauf es heute erlaubt.
Jens analysiert seit Jahren digitale Märkte, Preisbewegungen und Plattform-Strategien. Als Betreiber mehrerer datengetriebener Systeme wertet er täglich große Mengen an Produkt- und Trenddaten aus. Sein Fokus liegt auf Einordnung statt Hype: Was bedeutet eine Entwicklung wirklich für Nutzer, Preise und Märkte?