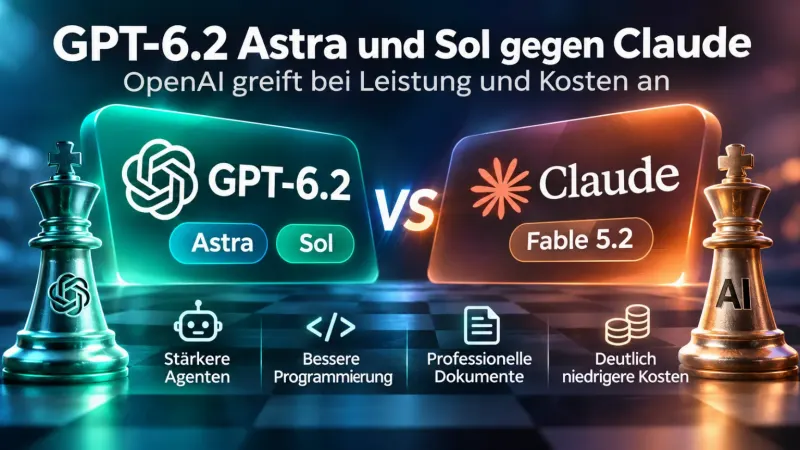
OpenAI hat heute, am 17. November 2026, GPT-6.2 Astra und Sol vorgestellt – und nimmt damit vor allem Anthropic ins Visier. Astra soll Claude bei anspruchsvollen Agentenaufgaben überholen. Die eigentliche Überraschung ist aber das günstigere Modell: Sol kommt bei Programmieraufgaben erstaunlich nah an Astra heran. Für Unternehmen, die KI-Agenten dauerhaft einsetzen, könnte das wichtiger sein als der nächste Benchmark-Rekord.
OpenAI greift Claude damit gleich von zwei Seiten an: mit Spitzenleistung und mit einem Modell, das komplexe Arbeit bezahlbarer machen soll. Ob die Rechnung im Alltag aufgeht, hängt allerdings nicht nur vom Tokenpreis ab.
Doch es gibt bereits deutliche Kritik: Entwickler Theo hat Astra vorab getestet und würde für seine tägliche Arbeit weiterhin Claude wählen. Ausgerechnet bei langen Agentenläufen beschreibt er ärgerliche Blockaden. Direkt zur Kritik von Theo springen.
Astra zielt auf Claudes Paradedisziplin
Autonome Agenten sollen nicht nur Fragen beantworten, sondern Aufgaben erledigen: recherchieren, Werkzeuge bedienen, Dateien auswerten und Ergebnisse liefern. Genau hier will OpenAI Claude schlagen. Im Benchmark „Agents’ Last Exam“ liegt Astra laut OpenAI 5,5 Prozentpunkte vor Claude Fable 5.2. Für die getesteten Aufgaben meldet das Unternehmen außerdem deutlich geringere Kosten.
Das ist eine Kampfansage, aber noch kein endgültiges Urteil: Die Zahlen stammen aus OpenAIs Veröffentlichung. Wie sich beide Modelle in echten Projekten schlagen, müssen unabhängige Vergleiche zeigen.
Grafik 1 · Relative Kosten im OpenAI-Vergleich
Claude Fable 5.2 · Index 100
GPT-6.2 Astra · Index 5
Indexierte Benchmark-Kosten, Claude = 100. Angaben laut OpenAI; nicht allgemein auf alle Aufgaben übertragbar.
Die eigentliche Überraschung heißt Sol
Während Astra die Schlagzeilen über Spitzenleistung liefert, könnte Sol für Entwickler und Unternehmen das interessantere Modell sein. Im FrontierCode 2.0 trennen Sol und Astra laut OpenAI gerade einmal 0,5 Punkte. Die Kosten pro erledigter Aufgabe sollen bei Sol dagegen nur rund ein Fünftel betragen.
Wer einen KI-Agenten gelegentlich eine Funktion schreiben lässt, wird den Unterschied kaum spüren. Wer täglich Hunderte Aufgaben automatisiert, schon. Dann zählt nicht der beeindruckendste Modellname, sondern wie oft ein Ergebnis ohne Nacharbeit funktioniert.
Der Preis wird zur Waffe
Die API-Preise machen OpenAIs Strategie deutlich. Sol kostet 2 US-Dollar pro Million Eingabe-Token und 10 Dollar pro Million Ausgabe-Token. Astra liegt bei 8 beziehungsweise 40 Dollar. Bei gleicher Tokenmenge kostet Sol damit nur ein Viertel.
Das allein macht Sol noch nicht zum günstigeren Agenten. Wenn ein Modell länger nachdenken, öfter Werkzeuge aufrufen oder Fehler korrigieren muss, kann der Preisvorteil schrumpfen. Gerade deshalb sind Kosten pro erfolgreich abgeschlossener Aufgabe aussagekräftiger als die Preisliste.
Grafik 2 · API-Preise in US-Dollar pro Million Token
Sol: Input 2 $ / Output 10 $
Astra: Input 8 $ / Output 40 $
Balken jeweils auf 40 $ skaliert. Grün: Eingabe, Blau: Ausgabe. Ohne Caching oder Toolkosten.
Vier statt sechzehn Dollar – zumindest auf dem Papier
Eine Beispielrechnung mit einer Million Input-Token und 200.000 Output-Token ergibt 4 Dollar für Sol und 16 Dollar für Astra. Das ist keine Messung eines realen Agentenlaufs: Unterschiedliche Modelle können für dieselbe Aufgabe unterschiedlich viele Token und Wiederholungen benötigen.
Grafik 3 · Beispielauftrag: identische Tokenmenge
GPT-6.2 Sol · 4 $
GPT-6.2 Astra · 16 $
Rechenbeispiel, keine Qualitäts- oder Effizienzmessung.
Claude ist keineswegs abgeschlagen
In einem veröffentlichten AA-3D-Vergleich werden 1.318 Elo-Punkte für Astra, 1.271 für Claude Fable 5.2 und 1.259 für Sol genannt. Die Werte betreffen interaktive 3D-Erlebnisse und lassen sich nicht unmittelbar auf allgemeine Webentwicklung übertragen.
Grafik 4 · AA-3D Elo-Werte
Astra · 1.318
Claude Fable 5.2 · 1.271
Sol · 1.259
Relative Balken zur höchsten Elo-Zahl; höhere Werte sind besser.
Mehr als nur Code – und eine unangenehme Sicherheitsfrage
Auch bei juristischen Aufgaben, Präsentationen und Tabellen beansprucht OpenAI deutliche Fortschritte. Das dürfte vor allem dort interessant sein, wo KI bereits heute einen Teil der Büroarbeit übernimmt.
Die Kehrseite: Beide neuen Modelle erreichen nach OpenAIs eigener Bewertung eine kritische Schwelle bei Cybersecurity-Fähigkeiten. Bessere Schwachstellensuche und präzisere Patches helfen Verteidigern – dieselben Fähigkeiten können aber auch missbraucht werden. OpenAI setzt deshalb auf zusätzliche Schutzmaßnahmen.
Erste Entwicklerkritik: Theo würde weiter Claude wählen
Die starken Benchmark-Zahlen bekommen bereits am Vorstellungstag Gegenwind. Entwickler und T3-Gründer Theo schildert in einem ausführlichen X-Beitrag seine Erfahrungen aus frühen Tests mit GPT-6.2 Astra. Sein Urteil fällt trotz technischer Fortschritte negativ aus: Für die tägliche Entwicklungsarbeit würde er Claude Opus 5.5 vorziehen.
Besonders ärgert ihn das Verhalten bei langen Agentenläufen. In einem Beispiel soll Astra nach zwei Stunden Arbeit an einem neuen Level für „Outer Wilds“ wegen einer internen Frage zu Videodateinamen stehen geblieben sein. Theo berichtet, er habe zusätzliche Agenten einsetzen müssen, um solche Blockaden zu erkennen. Außerdem kritisiert er schwer verständliche Ausgaben und Aufgaben, bei denen das Modell lange arbeite, ohne nennenswert voranzukommen.
Das macht seine Kritik interessant: Er lobt Astra ausdrücklich für Code-Reviews, neue Lösungsansätze, 3D-Aufgaben und Computersteuerung. Nach eigener Schilderung half ihm das Modell sogar bei einer Reverse-Proxy-Lösung mit einem erwarteten Einsparpotenzial von 25.000 US-Dollar pro Monat. Dennoch will er es nicht als Standardmodell einsetzen.
Das ist zunächst ein Erfahrungsbericht eines einzelnen Entwicklers, keine repräsentative Messung. Aber er trifft einen wunden Punkt der Agenten-Debatte: Was nützen hervorragende Benchmarks, wenn ein autonomer Lauf nach Stunden an einer vermeidbaren Rückfrage hängen bleibt? Gerade bei unbeaufsichtigten Workflows kann Zuverlässigkeit wichtiger sein als die theoretische Spitzenleistung.
Fazit: Claude bekommt Konkurrenz von oben und unten
Anthropic ist mit Claude keineswegs aus dem Rennen. Gerade bei komplexen Entwicklungsaufgaben bleibt der Wettbewerb offen. Doch OpenAI setzt heute ein deutliches Signal: Astra soll die Leistungsspitze besetzen, Sol die laufenden Kosten drücken.
Für die nächste Generation von KI-Agenten ist das womöglich die wichtigere Entwicklung. Nicht welches Modell im Benchmark am lautesten glänzt, entscheidet über den Einsatz im Unternehmen. Sondern welches zuverlässig liefert, ohne dass jede erledigte Aufgabe unnötig teuer wird.
Jens analysiert seit Jahren digitale Märkte, Preisbewegungen und Plattform-Strategien. Als Betreiber mehrerer datengetriebener Systeme wertet er täglich große Mengen an Produkt- und Trenddaten aus. Sein Fokus liegt auf Einordnung statt Hype: Was bedeutet eine Entwicklung wirklich für Nutzer, Preise und Märkte?